Mostrando entradas con la etiqueta visual. Mostrar todas las entradas

viernes, 29 de julio de 2016

Columnstore Index

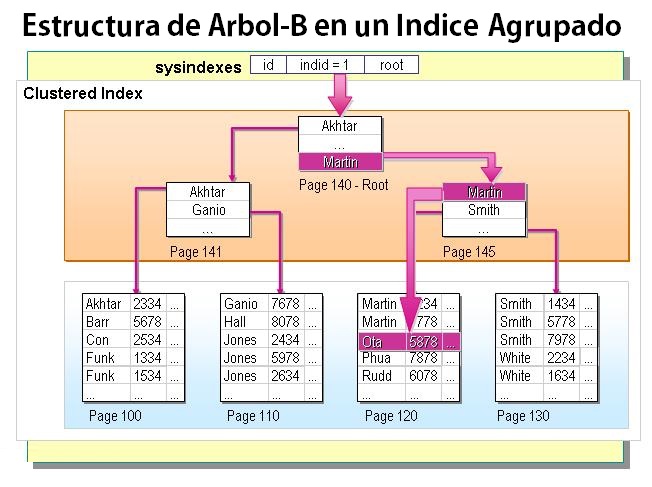
Los Columnstore Indexes presenta una nueva estructura almacenando  columnas en lugar de filas, y está diseñado para acelerar el procesamiento de análisis de consultas y datos en un data-warehouse. Pero se debe tener en cuenta que los índices de almacén en columnas aunque son eficaces, no son un vaso de agua en el desierto, ya que hay una serie de limitaciones en ellos. Cuando se usa apropiadamente, pueden reducir entradas y salidas de disco y utilizar la memoria de manera más eficiente. Desde SQL Server 2012, se puede definir Columnstore Indexes en las tablas de base de datos. Un Columnstore Indexes almacena los datos en un formato por columnas, a diferencia de las estructuras de árbol B tradicionales que se utilizan para los índices de almacenamiento de filas agrupados y no agrupados, que almacenan los datos de modo de fila (en filas).
ZnJvbT1jbmJsb2dzJnVybD1IQmxTdUVUTWpsR1V2UTNib1JYWnVCM2NoOVNidk4yWHpkMmJzSm1iajlTYnZObUx6ZDJic0ptYmo1eWNsZFdZdGwyTHZvRGMwUkhh
Un índice de columnas organiza los datos de las columnas individuales que se unen entre sí para formar el índice. Esta estructura puede ofrecer mejoras de rendimiento significativas para las consultas que resumen grandes cantidades de datos, como los utilizados normalmente para la inteligencia empresarial (BI) y almacenamiento de datos.

Estructura del Columnstore Index

Columnstore indexes se basan en xVelocity (anteriormente conocido como VertiPaq), una avanzada tecnología de almacenamiento y compresión que se originó con PowerPivot y Analysis Services, pero se ha adaptado a las bases de datos de SQL Server 2012. En el corazón de este modelo es la estructura columnar que agrupa los datos por columnas en lugar de filas. Para entender mejor cómo funciona esta estructura, vamos a ver una tabla sencilla (AUTOTYPE) que almacena los datos relacionados con el automóvil. El siguiente código T-SQL muestra la definición de la tabla:
CREATE TABLE TipoAuto (   AutoId INT NOT NULL,   
Marca VARCHAR(20) NOT NULL,
  
Modelo VARCHAR(20) NOT NULL,
  
Color VARCHAR(15) NOT NULL,
  
AñoModelo SMALLINT NOT NULL ,
CONSTRAINT PK_TipoAuto PRIMARY KEY CLUSTERED (AutoId)  )


Aquí no hay nada elaborado, sólo algunas columnas configuradas con los tipos básicos. Pero tenga en cuenta que la columna de la AutoID se configura como la clave principal e índice agrupado. Como es típico de un índice agrupado, los datos se ordenan físicamente en el disco en páginas de datos, como se ilustra en la Imagen de abajo.
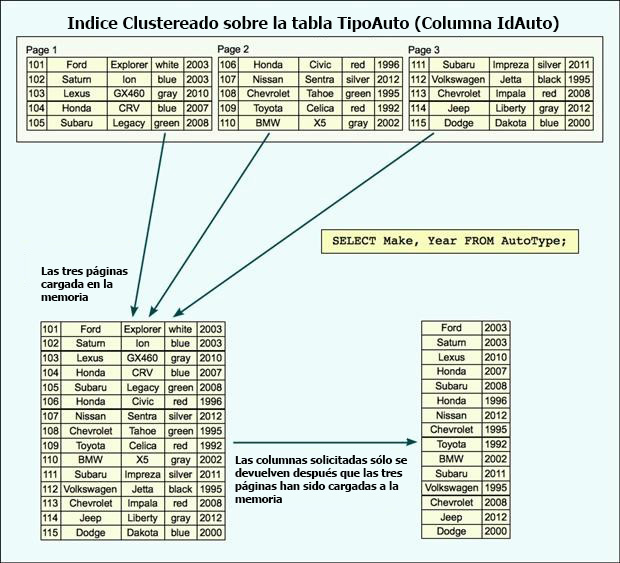
Column1

En este caso, los datos se dividen en tres páginas, con cada uno conteniendo cinco filas. Esto, por supuesto es un ejemplo en un escenario muy poco probable, ya que cada página normalmente contener muchos más datos, pero para fines de demostración, esta configuración debería funcionar bien. El punto importante a destacar es que cada fila se almacena en una página en su totalidad. Ahora supongamos que ejecute la siguiente consulta en la tabla TIPOAUTO:
SELECT Marca, AñoModelo FROM TipoAuto;
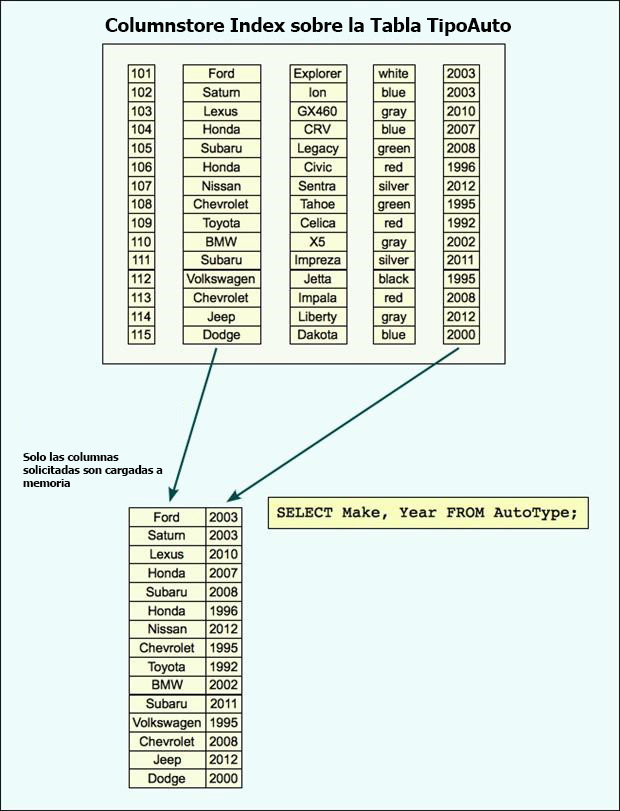
Cuando el motor de base de datos procesa la consulta, recupera las tres páginas de datos en la memoria, buscará toda la tabla a pesar de que la mayor parte de las columnas no son necesarios. En otras palabras, desperdiciara recursos de entrada y salida y memoria para recuperar datos innecesarios. Ahora veamos cuando se crea un columnstore index en la tabla. En este caso, hemos incluido todas las columnas en el índice, aunque en realidad probablemente habría que incluir soló algunas columnas. Cualesquiera que sean las columnas que incluimos, se almacenan en el índice, en algo similar a la imagen abajo. Como se puede ver, los datos ya no se almacenan por fila.
Column2

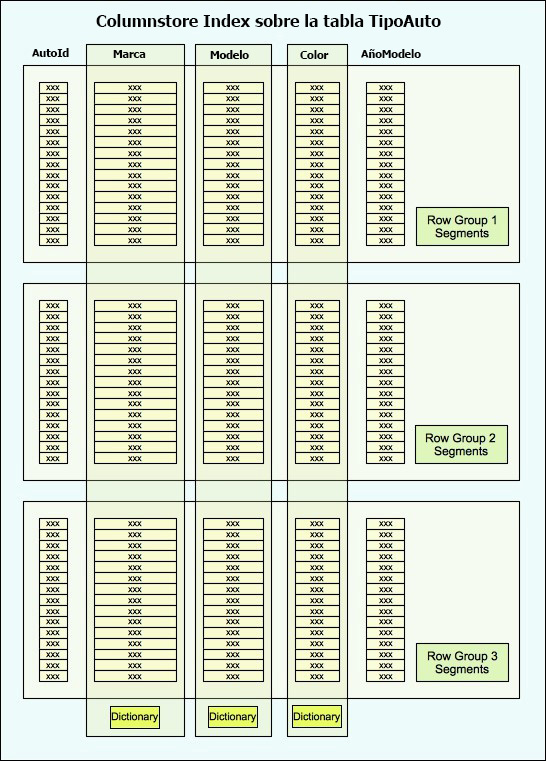
En el índice de columnas mostrado en la figura, cada columna es su propio segmento. Un segmento puede contener valores de una columna única, que permite que los datos de cada columna para acceder de forma independiente. Sin embargo, una columna puede abarcar varios segmentos, y cada segmento puede ser formado por varias páginas de datos. Los datos se transfieren desde el disco a la memoria por segmento, no por página. Un segmento es un objeto grande altamente comprimido (LOB) que pueden contener hasta un millón de filas. Los datos dentro del segmento de cada columna coinciden fila por fila para que las filas siempre se pueden montar correctamente. Por ejemplo, la segunda fila en cada segmento en la Imagen de arriba, apuntan al mismo automovil: el azul 2003 Saturn Ion con un IdAuto de 102. Las filas coincidentes en todos los segmentos forman un grupo de filas. Pronto nos ocuparemos de los grupos de filas en más detalle en breve, pero primero volvamos a la declaración SELECT. Si corremos la instrucción de nuevo, después de la creación de nuestro columnstore index, el procesador de consultas usará el columnstore index, en lugar del índice agrupado. Como resultado, sólo los segmentos asociados con el año, marca y el Modelo serán sacados en la memoria, lo que reduce los recursos necesarios para procesar la consulta. Esto es especialmente importante en las entradas y salidas de disco. A pesar de que hemos visto grandes saltos en el procesamiento y capacidad de memoria, El disco duro y sus entradas y salidas sigue siendo el eslabón más débil de una consulta, pero la estructura de columnas puede ayudar a reducir las E/S de manera significativa. Por supuesto, los datos de una columna no cabrán siempre en un solo segmento, dada la limitación de un millón de fila. En tales casos, múltiples segmentos se crean para cada columna y se agrupan en múltiples grupos de filas, una para cada conjunto de segmentos. Cuando un columnstore index se divide en varios grupos o segmentos de filas, cada grupo de filas contiene un conjunto de filas completas. Por ejemplo, la siguiente figura muestra el índice de almacén de columnas ahora dividida en tres grupos de filas. Cada grupo de filas contiene segmentos para cada columna, y juntos los segmentos forman el conjunto completo de filas.
Column3

Nótese que la figura de arriba muestra también varios diccionarios, cada uno asociado con una columna específica. Un diccionario codifica los valores de una columna configurada con un tipo de datos de cadena o, en algunos casos, un tipo no-string si la columna contiene unos valores distintos. Aunque no todas las columnas utilizan diccionarios, todas las columnas de cadenas de texto sí. Cuando se utiliza un diccionario, que almacena valores de datos reales de la columna, y los valores numéricos de referencia se insertan en los segmentos en lugar de esos valores. Esto puede ofrecer una gran ventaja en el rendimiento para las columnas que contienen muchos valores repetidos, pero puede tener un impacto negativo sobre columnas con una gran cantidad de valores únicos. Aun así, una columna de cadena siempre utiliza un diccionario primario e incluso podría utilizar un diccionario secundario.

Funcionamiento del Columnstore Index

Como se señaló anteriormente, una de las mayores ventajas que ofrece un columnstore index es la reducción de E/S, que puede tener un impacto directo en el rendimiento de las consultas. Sólo para dar una idea de esto, veamos un ejemplo sencillo. La siguiente instrucción SELECT recupera los datos de la tabla FactResellerSales en la base de datos de ejemplo AdventureWorksDW2012 que puede descargarse en https://msftdbprodsamples.codeplex.com/downloads/get/165405:

SELECT ProductKeyM, UnitPrice, CustomerPONumber, OrderDate FROM FactResellerSales;

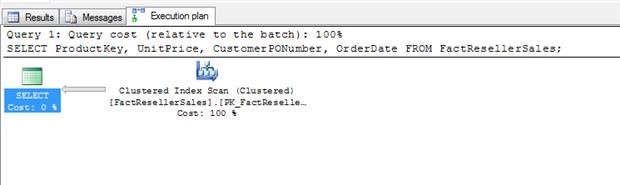
La definición de la tabla incluye una clave principal compuesta definida en las columnas SalesOrderNumber y SalesOrderLineNumber, que forman la base del índice agrupado de la tabla. Como resultado, cuando se ejecuta la consulta, el procesador de consultas realiza un recorrido de índice agrupado.
Column5

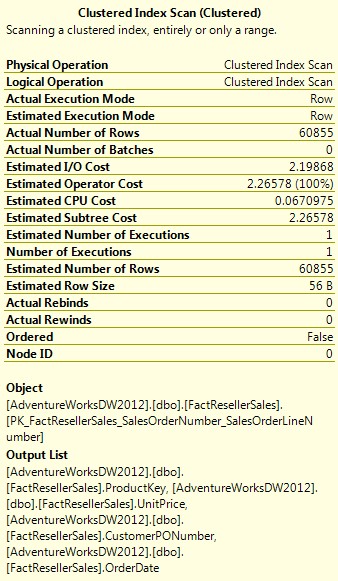
No hay nada demasiado sorprendente aquí. Puesto que la tabla contiene sólo 60.855 filas, la consulta se procesa de forma casi instantánea. Aún así, vale la pena echar un vistazo rápido a los detalles del plan de ejecución, que se muestra en la siguiente figura. En particular se nota el “Estimated I/O Cost” que es de 2,19868. Observe que esto representa una parte significativa de los costos totales de los operadores (Estimated Operator Cost) de 2,26578. El resto de los costos del operador va a la CPU, que está en el puesto solamente 0.0670975.
Column6
Ahora vamos a crear un índice de almacén de columnas en nuestra tabla. La siguiente sentencia crea un índice CSI_FactResellerSales con los campos ProductKey, Unitprice, CustomerPONumber y Orderdate:

CREATE NONCLUSTERED COLUMNSTORE INDEX CSI_FactResellerSales ON dbo.FactResellerSales (ProductKey, UnitPrice, CustomerPONumber, OrderDate);

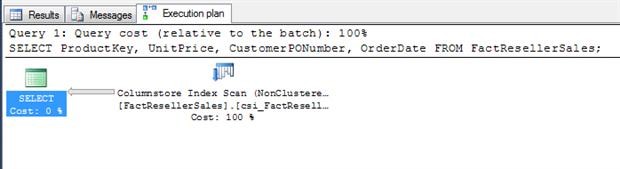
Crear de un ColumnStore Index es tan simple como crear cualquier tipo de índice no agrupado. Una vez que creamos el columnStore Index, podemos volver a ejecutar nuestra consulta. La instrucción SELECT una vez más vuelve nuestras filas instantáneamente, por el pequeño grupo de datos que es, pero produce un plan de ejecución diferente, veamos para esto la siguiente figura.
Column7
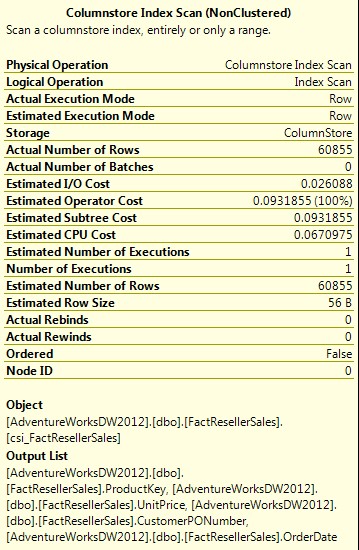
Como se puede ver, esta vez el procesador de consultas realiza un recorrido del Columstore index, en lugar de un recorrido de índice agrupado. Y si revisamos los detalles del plan de ejecución, que sigue abajo, revela una imagen muy diferente de E/S.
Column8


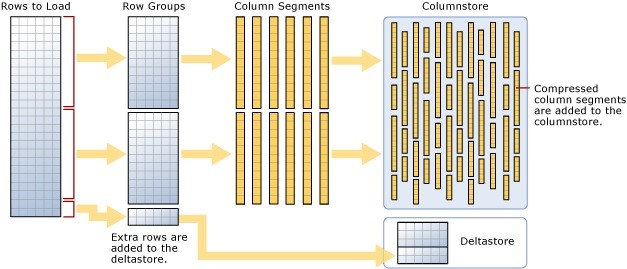
Nótese en primer lugar que los costos de la CPU son los mismos que para el índice agrupado: 0,0670975. Sin embargo, nuestro operador “Estimated Operator Cost” esta vez es sólo es 0.0931855, en comparación con 2,26578 para el índice agrupado. Esto se debe a nuestro costo de E/S es ahora sólo 0,026088, en lugar del 2,19868 devueltos por la consulta utilizando el índice agrupado. Este ejemplo es, sin duda, es sencillo, pero demuestra la naturaleza como el índice columnar puede reducir los costos de E/S en sus consultas. Sin embargo, la estructura del índice columnar no es el único aspecto que da lugar a mejoras del rendimiento. La compresión también desempeña un papel integral. Ya que los datos en un índice de columnas se agrupan por columnas, en lugar de por filas, los datos se pueden comprimir de manera más eficiente que con índices almacenados en filas. Los datos leídos desde una sola columna son más homogéneos que los datos leídos de filas, y cuanto más similares sean los datos, más fácil de comprimir. Además, si se le añade un bajo número de valores distintos y el uso de diccionarios, solo hay ventajas. La tecnología xVelocity también trae algoritmos de compresión sofisticados que pueden sacar el máximo provecho de la naturaleza columnar de los índices. Y la manera más eficaz de comprimir los datos, ya que más datos cabrán en una sola página y cuantos más datos se puede cargar en la memoria, menos costos de entradas y salidas de disco. Si se tiene en cuenta la naturaleza de las cargas de trabajo de BI, que a menudo implican la agregación de grandes conjuntos de datos, se puede ver la clara ventaja de la estructura de columnas. La necesidad de que el aumento de la potencia de la CPU que requiere dicha agregación puede ser compensado por los ahorros de E / S, lo que ayuda a mejorar el rendimiento de las consultas gigantescas.
Column9

Mejoras en SQL Server 2016

Column10

sábado, 15 de junio de 2013

Laboratorio de Active Directory y Group Policy


Clase grabada del 1 de Junio del Diplomado de Tecnología de redes Windows, donde se repasa con un laboratorio la promoción de un servidor a controlador de dominio, se unen maquinas al dominio y se aplican políticas.
En la demostración se aplican políticas de establecimiento de un papel tapiz, ejecución de un script al iniciar sesión, publicación de software a una unidad organizativa y se comprueba la jerarquía de Sitio, Dominio y Unidad Organizativa en el establecimiento de estas políticas.

martes, 11 de junio de 2013

Historia las Bases de Datos Relacionales con SQL y SQL Server de Microsoft

Un tema que me apasiona mucho, son las bases de datos, que en nuestro mundo de hoy son vitales y están presentes en casi cualquier actividad, en las finanzas de una empresa para llevar su registro de gastos e ingresos, en las universidad para llevar el control de notas de los alumnos, cuando vamos al cajero automático a sacar dinero estamos accediendo a la base de datos del banco y así podemos mencionar un sin número de actividades donde las bases de datos son vitales,    por esta razón  es  importante contar con los conceptos fundamentales si nuestro rol es administrativo y si es informático es un punto obligado, pero cuál es el origen de las bases de datos que usamos hoy en día y en especial del SQL Server de Microsoft, que por cierto usamos el modelo relacional. Pues déjenme contarles la historia.

En 1970 Edgar “Ted” Codd, matemático empleado por IBM, escribió un artículo que cambiaría todo lo anterior en bases de datos.  Codd propuso el modelo relacional y asociado a este un sub-lenguaje de acceso a los datos basado en el cálculo de predicados, en ese momento de la historia IBM tenía intereses en otro sistema, el IMS, un confiable y muy especializado sistema de base de datos que apareció en 1968 y que le rendía considerables ganancias, por lo que no se percató que las teorías de Codd encenderían una revolución tecnológica comparable al  internet o el perfeccionamiento de las computadoras personales.

Entonces Codd organizo un simposio donde redujo complicados programas de cinco páginas a un reglón, lo cual fue sensacional, el simposio convecino a IBM de patrocinar el sistema R, proyecto que construyo el sistema relacional y el lenguaje SEQUEL (Structured English Query Language) que posteriormente llevaría a la creación de SQL, sin embargo IBM al considerar que su mercado potencial  estaba con IMS engaveto por muchos años a sistema R y le dio libertad a Ted Codd para publicar sus artículos científicos.

Entre las personalidades en las que hizo eco las teorías de Codd estaba Larry Ellison, que acababa de crear una compañía, reclutando programadores del sistema R y de la universidad de California, lo que hizo que en 1979 Ellison pudiera vender la primera base de datos relacional mucho antes que IBM, posteriormente Ellison llamo a su empresa ORACLE

El SQL pasa a ser el lenguaje por excelencia de los diversos sistemas de gestión de bases de datos relacionales surgidos en los años siguientes como Sybase,  Postgrate, DB2 y es por fin estandarizado en 1986 por el ANSI, dando lugar a la primera versión estándar de este lenguaje, el "SQL-86" o "SQL1". Al año siguiente este estándar es también adoptado por la ISO.

Sin embargo, este primer estándar no cubre todas las necesidades de los desarrolladores e incluye funcionalidades de definición de almacenamiento que se consideró suprimirlas. Así que, en 1992, se lanzó un nuevo estándar ampliado y revisado del SQL llamado "SQL-92" o "SQL2".

En la actualidad el SQL es el estándar de la inmensa mayoría de los Sistemas Gestores de Base de datos comerciales. Y, aunque cada implementación comercial del lenguaje agrega características particulares, el soporte al estándar SQL-92 es general y muy amplio.
 

El SQL SERVER DE MICROSOFT


La aparición de Microsoft en el mundo de los SGBD basados en SQL se da en 1988  cuando en colaboración con SyBase , IBM y  Ashton-Tate, Microsoft decide crear  un sistema de gestión de base de datos para el sistema operativo OS/2,  sistema en el cual era copropietario junto con IBM, tiempo después se desarrolló la versión para Windows  NT en el año de 1993,  en ese entonces era un producto muy básico para todo el potencial que ha alcanzado hoy en día.

Al año siguiente en 1994 Sybase y Microsoft deciden dar por terminada su colaboración y SyBase se dedica al desarrollo de su base de dato y Microsoft a la suya.

Después de la separación un año más tarde en 1995 Microsoft Lanza su primera versión independiente y como único propietario y desarrollador de SQL Server con la versión  Microsoft SQL Server 6.0 una versión mejorada principalmente en rendimiento, y en el año de 1996 se lanza la versión Microsoft SQL Server 6.5 una versión que se mantuvo vigente 2 años antes de sacar una nueva versión en 1998, la 7.0 versión que  realizar mejoras considerables en cuanto usabilidad, potencia y rendimiento, convirtiéndose en una de las versiones más fuertes,  su avance fue tan significativo que pudo competir a sistemas como ORACLE o el propio DB2, y poco a poco colocarse como una propuesta atractiva a empresas que manejaban grandes volúmenes de datos por su funcionalidad y costo,  esta versión permaneció estable y con ligeras actualizaciones hasta el desarrollo de Microsoft SQL Server 2000 versión que  incorpora ediciones para diferentes roles comerciales una de ellas la edición de 64  bits, workgroup, desktop engine, profesional, personal, standard, developer, Enterprise, etc. y durante los siguientes 5 años comenzó a causarle delirios de persecución a los gigantes de las bases de datos como ORACLE,  IBM con DB2, SyBase, entre otros.

Para  la versión 2005 de SQL Server ya es un sistema gestor líder en el mercado, que permite desarrollar aplicaciones innovadoras, con herramientas de alta disponibilidad, escalabilidad, integración de datos, gestión y además con un poderoso conjunto de funciones de Inteligencia de Negocios para el  análisis y obtención de datos comprensibles superando por mucho en esta área a los otros productos en el mercado.

viernes, 2 de noviembre de 2012

¿Por qué usamos la "@" en las direcciones de correo electrónico?


¿Por qué usamos la "@" en las direcciones de correo electrónico?

Cuando el ingeniero Ray Tomlinson, que creó el e-mail en 1971, estaba buscando un símbolo que sirviese para identificar las direcciones de correo, uno de los pocos disponibles en los teclados era justamente la arroba. “Hubiese sido más fácil usar un corchete, un paréntesis o incluso una coma, pero estos símbolos ya eran utilizados para otros fines, y de los símbolos que quedaban libres, la @ era el mejor”, ha explicado hace algunos años Tomlinson. “Otro punto a favor de este símbolo es que al traducirse como at en inglés daba una sensación de localización”, agregó. La primera dirección de correo electrónico de la historia fue “tomlinson@bbn-tenexa”.nes, y de los símbolos que quedaban libres, la @ era el mejor”, ha explicado hace algunos años Tomlinson. “Otro punto a favor de este símbolo es que al traducirse como at en inglés daba una sensación de localización”, agregó. La primera dirección de correo electrónico de la historia fue “tomlinson@bbn-tenexa”.
nes, y de los símbolos que quedaban libres, la @ era el mejor”, ha explicado hace algunos años Tomlinson. “Otro punto a favor de este símbolo es que al traducirse como at en inglés daba una sensación de localización”, agregó. La primera dirección de correo electrónico de la historia fue “tomlinson@bbn-tenexa”.
 

sábado, 28 de julio de 2012

Codigo HTML Para Una Lista Desplegable con los Paises del Mundo


A veces se necesita un formulario en una página web, con una lista desplegable con los países del mundo, aquí el script HTML.

<select name="pais">
<option value="AF">Afganistán</option>
<option value="AL">Albania</option>
<option value="DE">Alemania</option>
<option value="AD">Andorra</option>
<option value="AO">Angola</option>
<option value="AI">Anguilla</option>
<option value="AQ">Antártida</option>
<option value="AG">Antigua y Barbuda</option>
<option value="AN">Antillas Holandesas</option>
<option value="SA">Arabia Saudí</option>
<option value="DZ">Argelia</option>
<option value="AR">Argentina</option>
<option value="AM">Armenia</option>
<option value="AW">Aruba</option>
<option value="AU">Australia</option>
<option value="AT">Austria</option>
<option value="AZ">Azerbaiyán</option>
<option value="BS">Bahamas</option>
<option value="BH">Bahrein</option>
<option value="BD">Bangladesh</option>
<option value="BB">Barbados</option>
<option value="BE">Bélgica</option>
<option value="BZ">Belice</option>
<option value="BJ">Benin</option>
<option value="BM">Bermudas</option>
<option value="BY">Bielorrusia</option>
<option value="MM">Birmania</option>
<option value="BO">Bolivia</option>
<option value="BA">Bosnia y Herzegovina</option>
<option value="BW">Botswana</option>
<option value="BR">Brasil</option>
<option value="BN">Brunei</option>
<option value="BG">Bulgaria</option>
<option value="BF">Burkina Faso</option>
<option value="BI">Burundi</option>
<option value="BT">Bután</option>
<option value="CV">Cabo Verde</option>
<option value="KH">Camboya</option>
<option value="CM">Camerún</option>
<option value="CA">Canadá</option>
<option value="TD">Chad</option>
<option value="CL">Chile</option>
<option value="CN">China</option>
<option value="CY">Chipre</option>
<option value="VA">Ciudad del Vaticano (Santa Sede)</option>
<option value="CO">Colombia</option>
<option value="KM">Comores</option>
<option value="CG">Congo</option>
<option value="CD">Congo, República Democrática del</option>
<option value="KR">Corea</option>
<option value="KP">Corea del Norte</option>
<option value="CI">Costa de Marfíl</option>
<option value="CR">Costa Rica</option>
<option value="HR">Croacia (Hrvatska)</option>
<option value="CU">Cuba</option>
<option value="DK">Dinamarca</option>
<option value="DJ">Djibouti</option>
<option value="DM">Dominica</option>
<option value="EC">Ecuador</option>
<option value="EG">Egipto</option>
<option value="SV">El Salvador</option>
<option value="AE">Emiratos Árabes Unidos</option>
<option value="ER">Eritrea</option>
<option value="SI">Eslovenia</option>
<option value="ES" selected>España</option>
<option value="US">Estados Unidos</option>
<option value="EE">Estonia</option>
<option value="ET">Etiopía</option>
<option value="FJ">Fiji</option>
<option value="PH">Filipinas</option>
<option value="FI">Finlandia</option>
<option value="FR">Francia</option>
<option value="GA">Gabón</option>
<option value="GM">Gambia</option>
<option value="GE">Georgia</option>
<option value="GH">Ghana</option>
<option value="GI">Gibraltar</option>
<option value="GD">Granada</option>
<option value="GR">Grecia</option>
<option value="GL">Groenlandia</option>
<option value="GP">Guadalupe</option>
<option value="GU">Guam</option>
<option value="GT">Guatemala</option>
<option value="GY">Guayana</option>
<option value="GF">Guayana Francesa</option>
<option value="GN">Guinea</option>
<option value="GQ">Guinea Ecuatorial</option>
<option value="GW">Guinea-Bissau</option>
<option value="HT">Haití</option>
<option value="HN">Honduras</option>
<option value="HU">Hungría</option>
<option value="IN">India</option>
<option value="ID">Indonesia</option>
<option value="IQ">Irak</option>
<option value="IR">Irán</option>
<option value="IE">Irlanda</option>
<option value="BV">Isla Bouvet</option>
<option value="CX">Isla de Christmas</option>
<option value="IS">Islandia</option>
<option value="KY">Islas Caimán</option>
<option value="CK">Islas Cook</option>
<option value="CC">Islas de Cocos o Keeling</option>
<option value="FO">Islas Faroe</option>
<option value="HM">Islas Heard y McDonald</option>
<option value="FK">Islas Malvinas</option>
<option value="MP">Islas Marianas del Norte</option>
<option value="MH">Islas Marshall</option>
<option value="UM">Islas menores de Estados Unidos</option>
<option value="PW">Islas Palau</option>
<option value="SB">Islas Salomón</option>
<option value="SJ">Islas Svalbard y Jan Mayen</option>
<option value="TK">Islas Tokelau</option>
<option value="TC">Islas Turks y Caicos</option>
<option value="VI">Islas Vírgenes (EEUU)</option>
<option value="VG">Islas Vírgenes (Reino Unido)</option>
<option value="WF">Islas Wallis y Futuna</option>
<option value="IL">Israel</option>
<option value="IT">Italia</option>
<option value="JM">Jamaica</option>
<option value="JP">Japón</option>
<option value="JO">Jordania</option>
<option value="KZ">Kazajistán</option>
<option value="KE">Kenia</option>
<option value="KG">Kirguizistán</option>
<option value="KI">Kiribati</option>
<option value="KW">Kuwait</option>
<option value="LA">Laos</option>
<option value="LS">Lesotho</option>
<option value="LV">Letonia</option>
<option value="LB">Líbano</option>
<option value="LR">Liberia</option>
<option value="LY">Libia</option>
<option value="LI">Liechtenstein</option>
<option value="LT">Lituania</option>
<option value="LU">Luxemburgo</option>
<option value="MK">Macedonia, Ex-República Yugoslava de</option>
<option value="MG">Madagascar</option>
<option value="MY">Malasia</option>
<option value="MW">Malawi</option>
<option value="MV">Maldivas</option>
<option value="ML">Malí</option>
<option value="MT">Malta</option>
<option value="MA">Marruecos</option>
<option value="MQ">Martinica</option>
<option value="MU">Mauricio</option>
<option value="MR">Mauritania</option>
<option value="YT">Mayotte</option>
<option value="MX">México</option>
<option value="FM">Micronesia</option>
<option value="MD">Moldavia</option>
<option value="MC">Mónaco</option>
<option value="MN">Mongolia</option>
<option value="MS">Montserrat</option>
<option value="MZ">Mozambique</option>
<option value="NA">Namibia</option>
<option value="NR">Nauru</option>
<option value="NP">Nepal</option>
<option value="NI">Nicaragua</option>
<option value="NE">Níger</option>
<option value="NG">Nigeria</option>
<option value="NU">Niue</option>
<option value="NF">Norfolk</option>
<option value="NO">Noruega</option>
<option value="NC">Nueva Caledonia</option>
<option value="NZ">Nueva Zelanda</option>
<option value="OM">Omán</option>
<option value="NL">Países Bajos</option>
<option value="PA">Panamá</option>
<option value="PG">Papúa Nueva Guinea</option>
<option value="PK">Paquistán</option>
<option value="PY">Paraguay</option>
<option value="PE">Perú</option>
<option value="PN">Pitcairn</option>
<option value="PF">Polinesia Francesa</option>
<option value="PL">Polonia</option>
<option value="PT">Portugal</option>
<option value="PR">Puerto Rico</option>
<option value="QA">Qatar</option>
<option value="UK">Reino Unido</option>
<option value="CF">República Centroafricana</option>
<option value="CZ">República Checa</option>
<option value="ZA">República de Sudáfrica</option>
<option value="DO">República Dominicana</option>
<option value="SK">República Eslovaca</option>
<option value="RE">Reunión</option>
<option value="RW">Ruanda</option>
<option value="RO">Rumania</option>
<option value="RU">Rusia</option>
<option value="EH">Sahara Occidental</option>
<option value="KN">Saint Kitts y Nevis</option>
<option value="WS">Samoa</option>
<option value="AS">Samoa Americana</option>
<option value="SM">San Marino</option>
<option value="VC">San Vicente y Granadinas</option>
<option value="SH">Santa Helena</option>
<option value="LC">Santa Lucía</option>
<option value="ST">Santo Tomé y Príncipe</option>
<option value="SN">Senegal</option>
<option value="SC">Seychelles</option>
<option value="SL">Sierra Leona</option>
<option value="SG">Singapur</option>
<option value="SY">Siria</option>
<option value="SO">Somalia</option>
<option value="LK">Sri Lanka</option>
<option value="PM">St Pierre y Miquelon</option>
<option value="SZ">Suazilandia</option>
<option value="SD">Sudán</option>
<option value="SE">Suecia</option>
<option value="CH">Suiza</option>
<option value="SR">Surinam</option>
<option value="TH">Tailandia</option>
<option value="TW">Taiwán</option>
<option value="TZ">Tanzania</option>
<option value="TJ">Tayikistán</option>
<option value="TF">Territorios franceses del Sur</option>
<option value="TP">Timor Oriental</option>
<option value="TG">Togo</option>
<option value="TO">Tonga</option>
<option value="TT">Trinidad y Tobago</option>
<option value="TN">Túnez</option>
<option value="TM">Turkmenistán</option>
<option value="TR">Turquía</option>
<option value="TV">Tuvalu</option>
<option value="UA">Ucrania</option>
<option value="UG">Uganda</option>
<option value="UY">Uruguay</option>
<option value="UZ">Uzbekistán</option>
<option value="VU">Vanuatu</option>
<option value="VE">Venezuela</option>
<option value="VN">Vietnam</option>
<option value="YE">Yemen</option>
<option value="YU">Yugoslavia</option>
<option value="ZM">Zambia</option>
<option value="ZW">Zimbabue</option>
</select>